【AWSマルチリージョン構成】第2章:Active-Active 構成のアーキテクチャ全体像と設計のポイント
前回の記事では、AWSにおけるマルチリージョン構成(Backup & Restore / Pilot Light / Active-Active)の比較と、データベース選定の考え方を整理しました。
本記事では、その中で最も高可用性のある「Active-Active + Aurora Global Database」の構成について、東京リージョンと大阪リージョン間で構築した事例のアーキテクチャを解説します。
1. 全体構成図
下図は、本件環境のアーキテクチャ全体像です。 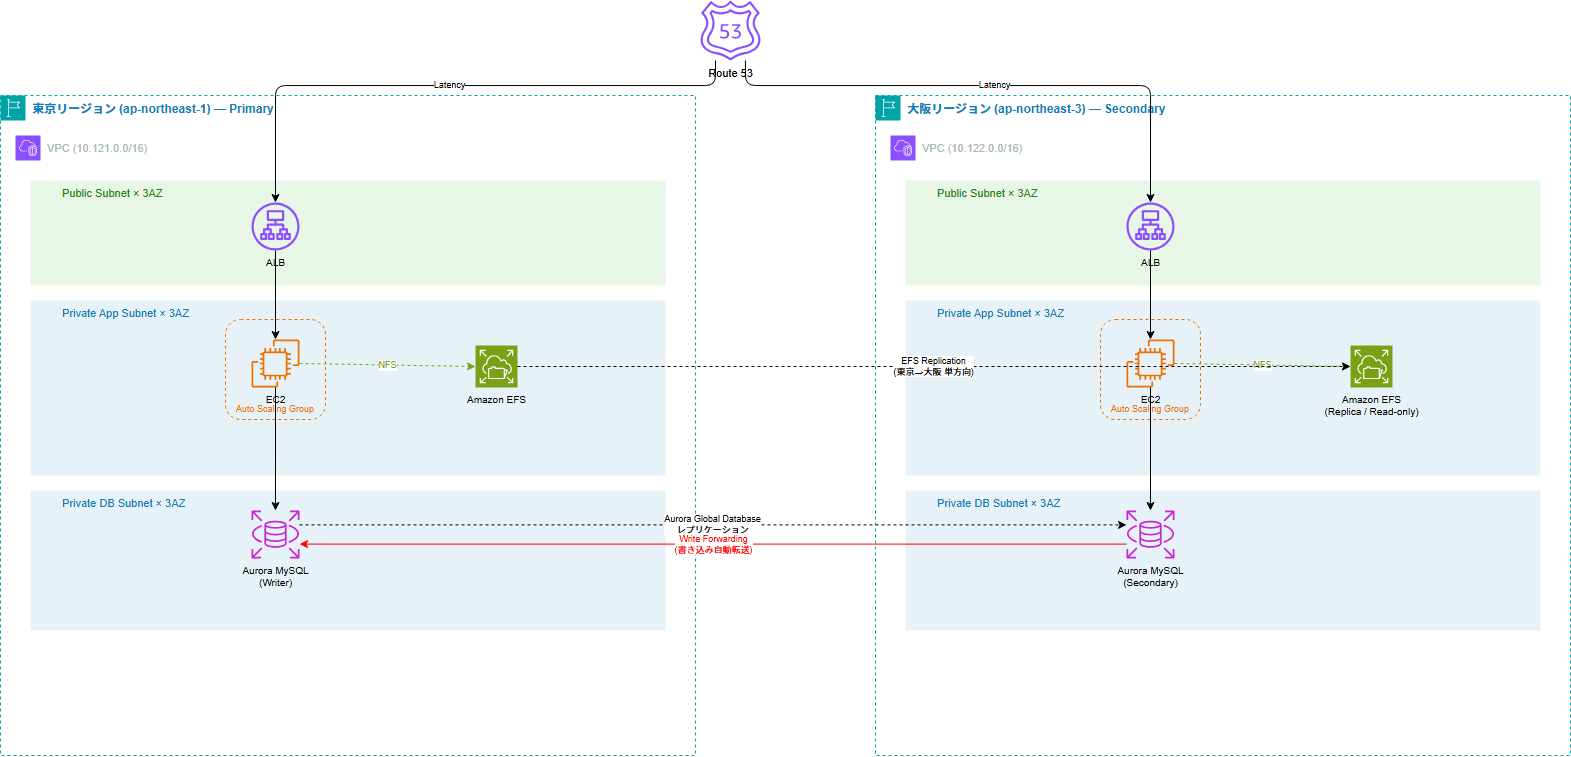 構成の要点は以下の通りです。
- 東京リージョン(Primary)と大阪リージョン(Secondary)で、VPC / ALB / EC2 / Aurora / EFS を対称的に配置
- 各リージョンは 3つのアベイラビリティゾーン (AZ) を使用し、マルチAZによる高可用性を確保
- Route 53 のレイテンシーベースルーティングにより、ユーザーを最寄りのリージョンへ誘導
- 片方に障害が発生したときはヘルスチェックにより自動的にトラフィックを健全なリージョンへ集約
トラフィック制御: Route 53 レイテンシーベースルーティング
Active-Active 構成におけるトラフィック制御のルーティングポリシーには、「Failover(フェイルオーバー)」ではなく「Latency(レイテンシー)」を選択しています。
Route 53 の Failover ポリシーは Primary/Secondary 型であり、正常時は片方のリージョンにしかトラフィックが流れません。これでは「両リージョンが常時Active」という要件を満たせないため、レイテンシーベースルーティングを採用しています。
レイテンシールーティングポリシーでは、ユーザーの地理的なネットワーク距離に応じて最もレイテンシーの低いリージョンの ALB が選択されます。さらに、各 ALB に対して Route 53 ヘルスチェックを関連付けることで、異常を検知したエンドポイントは自動的に除外され、結果的にフェイルオーバーと同等の動作が実現します。
※ 本件においては、ARC (Application Recovery Controller) 等の高度な管理サービスは使用せず、Route 53 の標準機能(レイテンシーベースルーティング + ヘルスチェック)のみで自動フェイルオーバーを構成しています。これは、「標準機能によるシンプルかつ安価な自動化」を重視した設計判断です。ARC によるゾーンシフトやロードバランサーの詳細な制御が必要となるケースでは、別途検討が必要です。
参考
- Route 53 レイテンシーベースルーティング
https://docs.aws.amazon.com/ja_jp/Route53/latest/DeveloperGuide/routing-policy-latency.html - Route 53 ヘルスチェックを使用した DNS フェイルオーバーの設定
https://docs.aws.amazon.com/ja_jp/Route53/latest/DeveloperGuide/dns-failover.html
2. 利用 AWS サービス一覧
本環境で使用した主要な AWS サービスを以下にまとめます。
| カテゴリ | サービス | 用途 |
|---|---|---|
| DNS / ルーティング | Route 53 | レイテンシーベースルーティング、ヘルスチェック、Private Hosted Zone |
| ロードバランシング | ALB (Application Load Balancer) | リージョンごとの HTTP/HTTPS トラフィック分散 |
| コンピューティング | EC2 + Auto Scaling Group | WordPress アプリケーションサーバ |
| イメージ管理 | EC2 Image Builder | 設定済みマスターイメージ(ゴールデンイメージ/AMI)の自動ビルドと配布 |
| データベース | Aurora Global Database (MySQL互換) | クロスリージョン レプリケーション + Write Forwarding |
| ストレージ | EFS (Elastic File System) | WordPress コンテンツ (wp-content) の共有。リージョン間レプリケーション |
| ストレージ | S3 | デプロイスクリプト、ゴールデンイメージのビルドログの格納 |
| 管理 / 運用 | Systems Manager (SSM) Parameter Store | DB パスワード等のシークレット管理 |
3. ネットワーク設計: リージョンを跨いだ 3層構造
VPC / サブネット構成
両リージョンのネットワークは、同一の論理構成を持つように設計しています。
| 層 | サブネット種別 | 配置リソース | 特徴 |
|---|---|---|---|
| 第1層 | Public Subnet × 3AZ | ALB, NAT Gateway | インターネットからのアクセスを受け付ける |
| 第2層 | Private App Subnet × 3AZ | EC2 (WordPress) | ALB 経由でのみアクセス可能 |
| 第3層 | Private DB Subnet × 3AZ | Aurora MySQL | App 層からのみアクセス可能 |
この3層分離構成を各リージョンで対称的に構築することで、フェイルオーバー時にも「切り替え先のリージョンで同一のネットワーク構成が利用できる」状態を保証しています。セキュリティグループも層ごとに分離し、通信は「ALB → EC2 → Aurora」の一方向のみを許可しています。
各リージョンの CIDR は 10.11.0.0/16(東京)と 10.12.0.0/16(大阪)など、リージョンごとに異なる CIDR を設定し、アドレス空間の衝突を防ぎます。
【設計上の注意点】NAT Gateway のシングル構成(コスト重視の設計判断)
本環境ではコスト抑制を優先し、各リージョンに NAT Gateway を1つだけ配置するシングル構成を採用しています。この場合、NAT Gateway を配置した AZ が障害を起こすと、他の AZ のプライベートサブネットからインターネットへのアウトバウンド通信が途絶えるリスクがあります。ただし、本環境ではアウトバウンド通信は主に SSM Agent や S3 へのアクセスに限られており、影響は限定的です。本番環境では各 AZ に NAT Gateway を配置する冗長構成を推奨します。
参考: NAT ゲートウェイを使用したシナリオ (AWS 公式)
https://docs.aws.amazon.com/ja_jp/vpc/latest/userguide/nat-gateway-scenarios.html
リージョン間接続の考え方
本件では、リージョン間の VPC Peering や Transit Gateway 等のプライベート接続は使用していません。
リージョン間のデータ同期は、Aurora Global Database のストレージレベルレプリケーション(AWSのバックボーンネットワーク経由)と、EFS Replication(同じく AWS 管理のレプリケーション経路)によって行われるため、ユーザー側で明示的なリージョン間ネットワーク接続を構築する必要がありません。
これは環境のシンプル化という目的もありますが、Active-Active 構成において「各リージョンが独立して自律的に動作できる」という設計思想にも合致しています。
4. データとストレージの同期戦略
Active-Active 構成の最大の技術的課題は、「両リージョンでデータをどう同期するか」にあります。本件では、データの種類に応じて2つの同期方式を使い分けています。
Aurora Global Database: DB層の同期
前回の記事で述べたとおり、Active-Active 構成で MySQL を利用する場合、Aurora Global Database が事実的に唯一の選択肢と言えます。
Aurora Global Database では、ストレージレベルの物理レプリケーションにより、東京(Primary Writer)から大阪(Secondary)へ通常1秒未満の低遅延でデータが同期されます。
【設計上の注意点】パラメータグループはリージョン間で自動同期されない
Aurora Global Database において、クラスターパラメータグループはリージョン間で自動的に同期されません。文字コード、タイムゾーン、監査ログ設定などはパラメータグループで管理されるため、東京・大阪の各リージョンで個別にパラメータグループを作成し、同一の設定を手動で適用する必要があります。これを怠ると、フェイルオーバー後にセカンダリが Primary に昇格したときに動作設定が異なる状態になります。
この構成で鍵となるのが Write Forwarding(書き込み転送)機能です。大阪リージョンの EC2 からローカルの Aurora に対して INSERT / UPDATE を発行すると、Aurora が自動的にそのクエリを東京の Writer インスタンスへ転送し、書き込みを完了させます。アプリケーション側(WordPress)に「書き込みは東京へ、読み込みは大阪へ」といった複雑な接続先の振り分けロジックを実装する必要がなく、アプリケーションの改修なしで Active-Active 構成を実現できる点が最大のメリットです。
ただし、この機能を利用するためには、アプリケーションの DB 接続時に以下のセッション変数を設定する必要があります。
SET @@aurora_replica_read_consistency = 'SESSION';この設定により、セッション内で書き込んだデータをすぐに読み取れる「セッションレベル一貫性」が保証されます。この設定がない場合、書き込み直後に自分のデータを読めないという不整合が発生する可能性があります。
この SET コマンドは、DB 接続が確立された直後に毎セッション実行される必要があります。既存のアプリケーションで、すべての接続に対して透過的にこれを適用する場合、大きく分けて「データベース側で強制する」か「アプリケーション側でフックする」かの2つのアプローチがあります。
アプローチ 1: Aurora クラスタパラメータ init_connect の活用
Aurora のカスタムパラメータグループにて init_connect パラメータに SET @@aurora_replica_read_consistency = 'SESSION'; を設定します。これにより、クライアントが接続を確立した直後に、MySQL 側で自動的にこの初期化クエリが実行されます。WordPress のようなアプリケーション側に一切の改修が不要になるというメリットがあります。
- ※ 注意: MySQLの仕様上、SUPER 権限を持つDBユーザー(マスターユーザーなど)の接続時には
init_connectが無視されます。アプリケーションからの接続には通常の(SUPER権限を持たない)専用ユーザーを使用するようにしてください。
参考: Amazon Aurora MySQL の DB クラスターパラメータグループと DB パラメータグループ
https://docs.aws.amazon.com/ja_jp/AmazonRDS/latest/AuroraUserGuide/AuroraMySQL.Reference.ParameterGroups.html
アプローチ 2: wp-content/db.php ドロップインの活用
アプリケーション側で制御したい場合の WordPress における手法です。標準の $wpdb クラスの接続ロジックを拡張し、mysqli_real_connect などの直後に自動でフックしてクエリを発行するカスタムクラスを配置します。
<?php
// wp-content/db.php
require_once ABSPATH . WPINC . '/class-wpdb.php';

class Aurora_wpdb extends wpdb {
    public function db_connect( $allow_bail = true ) {
        $connected = parent::db_connect( $allow_bail );
        if ( $connected && $this->dbh ) {
            mysqli_query( $this->dbh, "SET @@aurora_replica_read_consistency = 'SESSION'" );
        }
        return $connected;
    }
}

$wpdb = new Aurora_wpdb( DB_USER, DB_PASSWORD, DB_NAME, DB_HOST );
【設計上の注意点】フェイルオーバー時は Write Forwarding が停止し、PHZ の手動更新が必要
Write Forwarding はセカンダリクラスターが Primary に昇格すると自動的に停止します。フェイルオーバー後は大阪クラスターが新 Primary(Writer)になるため、大阪 VPC の PHZ レコードを Reader Endpoint → Writer Endpoint へ手動で更新する必要があります。この切替を行わないと、アプリケーションは昇格後も Reader Endpoint へ接続し続け、書き込みエラーが発生します。
参考
- Amazon Aurora Global Database の使用
https://docs.aws.amazon.com/ja_jp/AmazonRDS/latest/AuroraUserGuide/aurora-global-database.html - Aurora MySQL での書き込み転送の使用
https://docs.aws.amazon.com/ja_jp/AmazonRDS/latest/AuroraUserGuide/aurora-global-database-write-forwarding.html - Aurora Global Database のフェイルオーバー
https://docs.aws.amazon.com/ja_jp/AmazonRDS/latest/AuroraUserGuide/aurora-global-database-disaster-recovery.html
EFS Replication: ファイルストレージの同期
WordPress の wp-content ディレクトリ配下に保存される画像、プラグイン、テーマ等の非構造化データは、EFS (Elastic File System) に格納し、AWS の EFS Replication 機能を利用して東京から大阪へ非同期で同期しています。
| 項目 | 内容 |
|---|---|
| 同期方向 | 東京 → 大阪(単方向) |
| 同期方式 | 非同期(ニアリアルタイム) |
| 大阪側の状態 | 読み取り専用(Read-only) |
| フェイルオーバー時 | レプリケーション削除により書き込み可能化(昇格) |
EFS Replication は一方向であるため、通常運用では大阪側の EFS は読み取り専用です。フェイルオーバーで大阪を Primary として完全稼働させるためには、レプリケーションを解除して大阪 EFS を書き込み可能にする「昇格」操作が必要になります。
【設計上の注意点】EFS Replication の遅延特性と昇格時の留意事項
EFS Replication は非同期方式であり、同期遅延が発生するため、東京にアップロードされたファイルが即座に大阪で利用できると前提に運用設計することは避けてください。また、フェイルオーバー時のレプリケーション削除(昇格操作)は、EFS サービス内部の同期状態に依存した非同期処理であり、完了までの時間はユーザー側で制御できません。フェイルオーバー計画において EFS 昇格の RTO はコンソールのステータスを目視しながら対応する手動作業であり、十分な余裕時間を見込んでおく必要があります。
※ 本構成ではファイルストレージに EFS を採用していますが、本番環境でアクセス量が増加する場合は、S3 + CloudFront によるメディアオフロード構成への移行を検討した方が良いでしょう。これにより EC2 への画像配信負荷を軽減でき、グローバル配信のパフォーマンスも向上します。
参考
- Amazon EFS レプリケーション
https://docs.aws.amazon.com/ja_jp/efs/latest/ug/efs-replication.html
【設計のポイント】ステートフルリソースにおける「昇格」の必要性
「Active-Active」構成といえども、Web システムを構成するすべてのレイヤーが完全に並列して「マスター」として振る舞えるわけではありません。本構成では、EC2 (App層) と DNS (トラフィック層) は完全な Active-Active として稼働しますが、データやファイルを保管するステートフルなリソース(DB層・ストレージ層)は、裏側の基盤技術としては Primary/Secondary のアーキテクチャ(Active-Passive)で動いています。
そのため、東京リージョン(Primary)に致命的な障害が発生した際は、完全なサービス復旧のために必ず以下のリソースで「昇格(Promotion)」と呼ばれる操作が必要になります。
- Aurora Global Database: 大阪のセカンダリクラスターを Primary へ昇格させ、新しい Writer エンドポイントを稼働させる。
- EFS Replication: レプリケーション設定を削除(解除)し、大阪の EFS を読み取り専用から書き込み可能なステータスへ昇格させる。
「Web アプリの閲覧」自体はヘルスチェックと DNS ルーティングによって数分で自動復旧(縮退運転)しますが、運用管理者によるバックエンドでの「昇格」作業と DNS (PHZ) の紐付け切り替えが完了するまでは、システム全体の完全稼働(書き込み機能の復旧)はできないという点を、アーキテクチャ上の重要な制約として理解しておく必要があります。
コラム: ステートフルリソースの「自動昇格」は可能か?
技術的には、Route 53 のヘルスチェックアラームをトリガーとして EventBridge と AWS Lambda(または Step Functions)を組み合わせることで、Aurora や EFS の昇格から PHZ の書き換えまでを完全自動化することは可能です。
しかし、実運用ではネットワークの瞬断などをトリガーに誤動作し、両リージョンが独立して「マスター」化してしまう「スプリットブレイン問題」や、レプリケーション遅延発生中の強制フェイルオーバーによる「意図しないデータ消失」を防ぐための高度な排他制御が必要になります。
そのため、「App層のフェイルオーバーは自動で行い(閲覧は自律復旧)、データベースやストレージの昇格などの破壊的・非可逆的な変更は、管理者の判断を挟むワンクリック・フェイルオーバー(自動化スクリプトの手動トリガー)の状態に留める」というアプローチも、安全性とコストのバランスが取れた構成であると考えられます。
※ 具体的なフェイルオーバーの切替手順や、昇格にかかるRTO(目標復旧時間)については、本記事の第4章(フェイルオーバー試験)で詳細にレポートします。
5. デプロイとイメージ配布の自動化
Active-Active 構成では、「両リージョンで全く同じアプリケーション環境を維持する」ことが運用上の重要課題です。本件では、EC2 Image Builder を活用してこの課題に対応しています。
ゴールデンイメージの自動ビルド
両リージョンで全く同一のサーバ環境を迅速に立ち上げるための鍵となるのが、「ゴールデンイメージ」の活用です。これは、OS のインストールからミドルウェアの設定、アプリケーションのデプロイまでを完了させた状態の「マスターテンプレート」を指し、AWS においては Amazon Machine Image (AMI) として管理されます。
EC2 Image Builder のパイプラインを東京リージョンに構築し、以下をすべて組み込んだゴールデンイメージを自動生成しています。
- OS (Ubuntu 24.04 LTS)
- Web サーバ (Apache + PHP)
- WordPress 本体(
wp-cli) - 必要な PHP 拡張モジュール(
php-mysql,php-gd等) - EFS マウントユーティリティ(
efs-utils) - AWS CLI
ビルドの各ステップは S3 に配置したシェルスクリプトによってコード化されており、再現性のあるイメージ生成が可能です。
ゴールデンイメージのマルチリージョン配布
Image Builder のディストリビューション設定により、東京でビルドしたイメージは自動的に大阪リージョンへもコピーされます。これにより、両リージョンの Auto Scaling Group が常に同一バージョンのゴールデンイメージ(AMI)からインスタンスを起動でき、環境の乖離を防止できます。 起動テンプレートの User Data には、リージョン固有のパラメータ(EFS ファイルシステム ID、リージョン名など)を環境変数として埋め込む設計としています。これにより、イメージ自体はリージョン非依存のまま、起動時にリージョンに応じた設定が適用されます。
参考
- EC2 Image Builder とは
https://docs.aws.amazon.com/ja_jp/imagebuilder/latest/userguide/what-is-image-builder.html
6. DB 接続エンドポイントの設計: Private Hosted Zone スプリットビュー
Active-Active 構成における DB 接続設計で特に工夫した点が、Route 53 Private Hosted Zone (PHZ) のスプリットビュー構成です。
課題
Aurora Global Database では、各リージョンに個別のクラスターエンドポイントが存在します。アプリケーションが直接エンドポイントを指定する場合、リージョンごとに異なる接続先設定を管理する必要があり、運用が煩雑になります。
解決策: 同一 FQDN による透過的接続
各リージョンの VPC に同名のプライベートホストゾーン(例: db.internal.example.com)を作成し、それぞれのゾーンで同一のレコード名を、自リージョンの Aurora エンドポイントに解決するように設定しています。
| リージョン | PHZ のレコード値 | 理由 |
|---|---|---|
| 東京(Primary) | Aurora Writer Endpoint | 直接書き込み可能 |
| 大阪(Secondary) | Aurora Reader Endpoint | Write Forwarding 経由で書き込み転送 |
この構成により、WordPress の wp-config.php には db.internal.example.com という単一のホスト名だけを設定すれば、各リージョンの EC2 は自動的にローカルの Aurora に接続します。フェイルオーバー時も DNS 設定の変更で対応でき、アプリケーションの設定変更は不要です。
【設計上の注意点】セカンダリリージョンの Writer Endpoint は Inactive(仕様)
上表で大阪を Reader Endpoint に設定している理由は、Aurora Global Database の仕様に起因します。セカンダリリージョンのクラスターでは、Writer Endpoint は仕様上 Inactive 状態となっており、接続できません。そのため大阪の接続先は必ず Reader Endpoint を選択する必要があります。Write Forwarding が有効であれば、Reader Endpoint 経由で書き込みクエリは自動的に東京の Primary Writer に転送されるため、アプリケーションからは違いを意識する必要はありません。
【設計上の注意点】PHZ 解決に必要な VPC の DNS 設定
PHZ (Private Hosted Zone) を正しく機能させるには、VPC に対して enableDnsSupport と enableDnsHostnames の両方を true に設定する必要があります。enableDnsSupport はデフォルトで true ですが、enableDnsHostnames はデフォルトで false のため、見落としやすい落とし穴です。この設定が漏れると PHZ のレコードが NXDOMAIN で解決に失敗し、アプリケーションから DB に接続できない状態になります。VPC 作成後は必ず両属性の有効化を確認してください。
なぜグローバルライターエンドポイントを使わないのか
Aurora Global Database には、自動的に Primary の Writer を指すグローバルライターエンドポイントが存在します。しかし、このエンドポイントを使用すると、大阪のアプリケーションからの通信も常に東京へ直接接続してしまいます。これでは以下の問題が生じます。
- 大阪からの読み取り(
SELECT)も東京経由となり、ローカルリードの利点が失われる - 大阪のクラスターを経由しないため、Write Forwarding の恩恵を受けられない
そのため、各リージョンのアプリケーションが「自リージョンのクラスターエンドポイント」に接続することが Active-Active 構成の正しいアプローチです。PHZ スプリットビューは、この要件を透過的に実現する手段です。
参考
- Amazon Aurora のグローバルライターエンドポイント
https://docs.aws.amazon.com/ja_jp/AmazonRDS/latest/AuroraUserGuide/aurora-global-database-endpoints.html - プライベートホストゾーンの使用
https://docs.aws.amazon.com/ja_jp/Route53/latest/DeveloperGuide/hosted-zones-private.html - VPC の DNS 属性
https://docs.aws.amazon.com/ja_jp/vpc/latest/userguide/vpc-dns.html - Aurora Global Database の接続管理
https://docs.aws.amazon.com/ja_jp/AmazonRDS/latest/AuroraUserGuide/aurora-global-database-connecting.html
7. まとめと次回予告
本記事では、Active-Active 構成の環境について、以下のアーキテクチャ要素を解説しました。
- Route 53 レイテンシーベースルーティングによる自動トラフィック制御
- 3AZ × 3層の対称的なネットワーク設計
- Aurora Global Database + Write Forwarding による改修レスの DB 同期
- EFS Replication によるファイルストレージの単方向同期
- EC2 Image Builder によるゴールデンイメージの自動ビルドとマルチリージョン配布
- Private Hosted Zone スプリットビューによる透過的な DB 接続
この構成の最大の特長は、「常時稼働」であるがゆえに、いざという時に「切り替わらないリスク」が極めて低い点です。Pilot Light 構成のように「普段動いていない環境がいざという時に正しく起動するか」を心配する必要がなく、両リージョンが日常的に本番トラフィックを処理しているため、問題があれば平時のうちに発見できます。
次回の記事では、この構成に対して実際に「東京リージョン全損」を想定したフェイルオーバー試験を実施し、各レイヤー(App / DB / Storage)の切り替え手順を公開します。